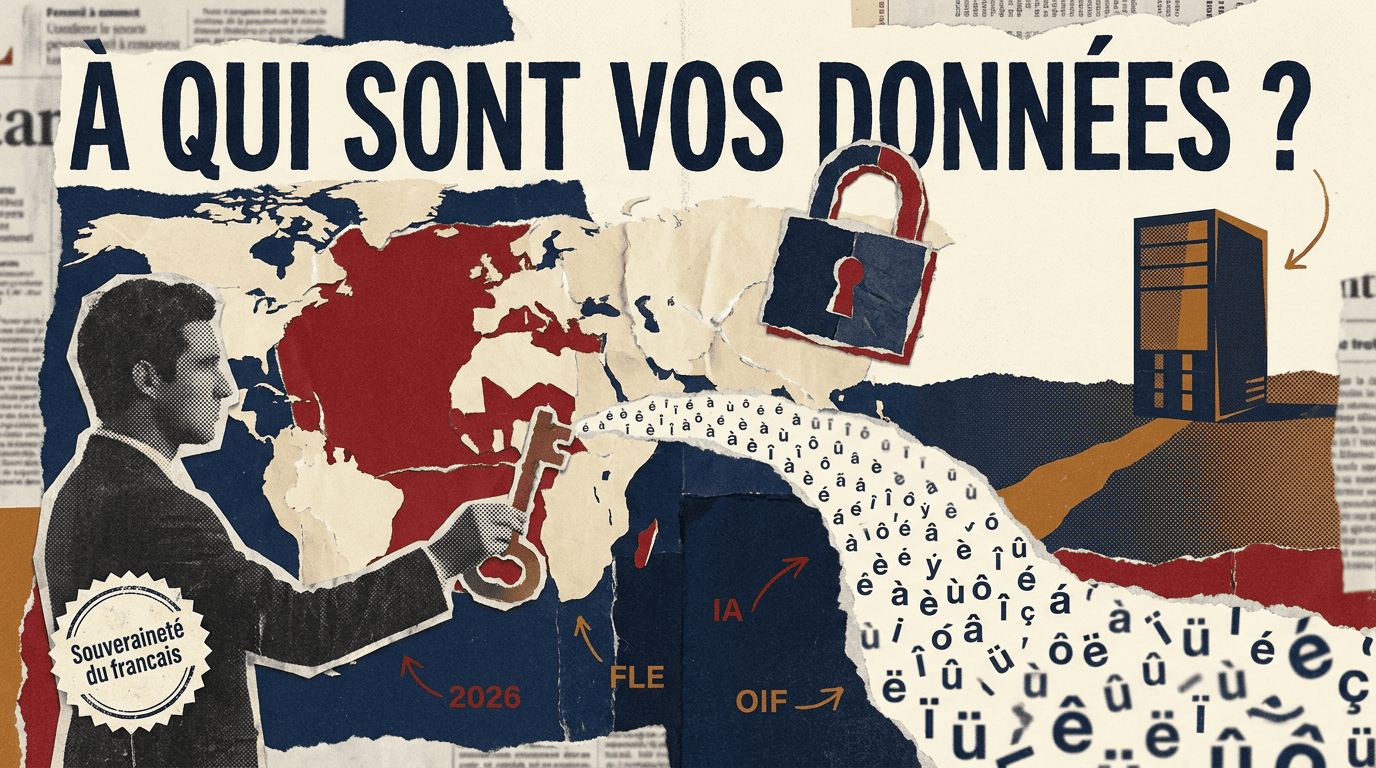
À qui appartiennent les données d’apprentissage du français ?

Synthèse
- Aujourd’hui, un géant coté de l’apprentissage des langues publie ses résultats trimestriels : l’occasion de poser la vraie question.
- À qui appartiennent les données d’apprentissage du français que produisent des millions d’apprenants ?
- Derrière ce débat se joue la souveraineté de notre langue : qui héberge, qui entraîne les modèles, qui définit la norme.
Le jour où la Bourse note l’apprentissage des langues
Ce 5 août, un grand acteur mondial de l’apprentissage des langues publie ses résultats du deuxième trimestre. Les marchés scruteront la croissance des utilisateurs, les revenus, la marge dopée à l’IA. C’est un rituel utile : il donne le pouls d’un marché. Mais il escamote une question que je trouve autrement plus importante pour notre secteur : à qui appartiennent les données d’apprentissage du français produites, chaque jour, par des millions de personnes ? Chaque exercice fait, chaque erreur corrigée, chaque phrase enregistrée est une donnée. Et cette donnée, aujourd’hui, échappe très largement au monde francophone.
Je pose la question sans naïveté commerciale. Les plateformes mondiales généralistes ne sont pas des méchants de dessin animé : elles ont démocratisé l’accès aux langues, et c’est un mérite réel. Mais quand un apprenant du Caire, de Bogota ou de Lagos apprend le français sur un écosystème anglo-saxon des langues, il ne fait pas que consommer un service : il alimente un modèle, quelque part, avec de la matière première linguistique française. La vraie question n’est pas « est-ce gratuit ? » ; c’est « qui capitalise ? ».
La donnée, nouvelle matière première du FLE
Longtemps, la valeur d’une méthode de langue tenait dans son contenu : le manuel, l’exercice, le cours. Aujourd’hui, la valeur bascule vers autre chose : la trace d’apprentissage. Savoir comment un hispanophone se trompe sur le subjonctif, à quel rythme un arabophone acquiert la liaison, quelles activités font vraiment progresser au B1 — voilà l’or du secteur. Cette donnée entraîne les modèles, personnalise les parcours et, à terme, définit ce qu’est un « bon » apprentissage du français.
Or cette matière première se concentre là où sont les utilisateurs, c’est-à-dire sur quelques plateformes de masse non spécialisées. Le paradoxe est saisissant : le français est une langue dont la vitalité se joue de plus en plus en Afrique et dans les Suds, mais dont la donnée d’apprentissage s’accumule dans des infrastructures qui ne relèvent ni de la francophonie, ni d’un projet éducatif francophone. On exporte la langue ; on importe des modèles entraînés sur nos propres apprenants.
Pourquoi c’est un débat de souveraineté
Le rapport 2026 de l’OIF a eu le mérite de nommer le problème : à l’ère de l’IA, la maîtrise des données conditionne l’autonomie culturelle et éducative. Pour le français, cela veut dire trois choses très concrètes. Premièrement, l’hébergement : où sont stockées les productions des apprenants, et sous quelle juridiction ? Deuxièmement, l’entraînement : quels modèles apprennent de ces données, et à qui profitent-ils ? Troisièmement, et c’est le plus sensible, la norme : qui définit le « bon niveau » de français ?
Cette dernière question me tient particulièrement à cœur. Si l’évaluation du français se fait demain par des algorithmes conçus ailleurs, entraînés sur des critères qui nous échappent, alors nous aurons délégué à d’autres le pouvoir de dire ce que parler français veut dire. C’est exactement ce que j’appelle la souveraineté de l’enseignement du français : non pas un repli, mais la volonté de garder la main sur la définition, la mesure et la transmission de notre langue.
Ce que répondent, en toute bonne foi, les défenseurs des plateformes
Soyons honnêtes avec l’autre camp, car le débat le mérite. Les partisans des grandes plateformes avancent des arguments sérieux : elles touchent des publics que nul institut n’atteindrait ; elles investissent des sommes qu’aucun acteur francophone ne peut aligner ; et la donnée, disent-elles, sert d’abord à améliorer l’expérience de l’apprenant. Ils ajoutent, non sans raison, que la souveraineté ne doit pas devenir un prétexte au protectionnisme ou à une technologie de moins bonne qualité. Ce sont des objections recevables. La bonne réponse n’est pas de fermer la porte aux outils mondiaux, mais de refuser qu’ils soient la seule option.
Une autre voie est possible
Entre le rejet des plateformes et la soumission totale, il existe un chemin : construire, dans le monde francophone, des outils capables de garder la donnée et la norme du côté de la langue. C’est la logique d’une évaluation souveraine du niveau de français, pensée et hébergée dans un cadre francophone, comme nous l’avons fait avec Test-FR : mesurer le niveau par l’IA sans confier cette mesure — ni les données qui la nourrissent — à un tiers dont ce n’est pas la langue. C’est aussi la logique d’un LMS de nouvelle génération dédié au FLE, où les traces d’apprentissage servent le professeur et le secteur, pas un modèle lointain.
Je ne prétends pas que ce soit simple. Il faut des moyens, du temps, une volonté collective. Mais la première étape est de poser la question au bon endroit : non pas « quelle plateforme a la meilleure marge ? », mais « qui garde la clé de nos données ? ». Le jour où le secteur du FLE traitera la donnée d’apprentissage comme un actif souverain, et non comme un sous-produit gratuit, il aura changé de position dans le rapport de force. Le débat est ouvert, et il vous appartient autant qu’à moi.
Tableau : trois questions, deux logiques
| Question | Plateforme mondiale généraliste | Approche souveraine francophone |
|---|---|---|
| Où sont hébergées les données ? | Infrastructures hors du monde francophone | Cadre et juridiction francophones |
| Qui entraîne les modèles ? | L’acteur privé, pour son propre compte | Le secteur du FLE, pour ses apprenants |
| Qui définit la norme du « bon français » ? | Des critères externes, opaques | Les référentiels francophones (CECRL) |
| À quoi sert la donnée ? | Améliorer un produit et sa valorisation | Servir le professeur et le pilotage qualité |
| Quel modèle économique ? | Gratuité contre données et attention | Valeur transparente, donnée maîtrisée |
FAQ : données d’apprentissage et souveraineté du français
Que sont les données d’apprentissage du français ?
Ce sont toutes les traces produites quand quelqu’un apprend le français : exercices réalisés, erreurs, réponses, enregistrements oraux, rythme de progression. Agrégées, elles permettent d’entraîner des modèles d’IA, de personnaliser les parcours et, à terme, de définir ce qu’est un bon niveau de français.
Pourquoi ces données posent-elles un enjeu de souveraineté ?
Parce qu’elles se concentrent sur des plateformes mondiales situées hors du monde francophone. Celui qui héberge et exploite ces données maîtrise l’entraînement des modèles et, potentiellement, la norme d’évaluation du français. Le rapport 2026 de l’OIF souligne que la maîtrise des données conditionne l’autonomie éducative et culturelle.
Faut-il pour autant rejeter les plateformes mondiales ?
Non. Elles ont démocratisé l’accès aux langues et touchent des publics considérables. L’enjeu n’est pas de les interdire, mais de refuser qu’elles soient la seule option, en construisant des alternatives francophones capables de garder la donnée et la norme du côté de la langue.
Quelle alternative souveraine existe pour le FLE ?
Deux briques complémentaires : une évaluation du niveau par l’IA pensée et hébergée dans un cadre francophone, comme Test-FR, et un LMS de nouvelle génération dédié au FLE, où les traces d’apprentissage servent le professeur et le secteur plutôt qu’un modèle lointain.
Liens utiles :
- « La langue française dans le monde 2026 » : données actualisées — OIF
- Synthèse du rapport « La langue française dans le monde 2026 » (PDF) — OIF
- L’IA au service de l’éducation : la logique de souveraineté — Éducation nationale
À lire aussi sur TooFrench :
Mettez ces idées en pratique avec vos apprenants
Réunissez vos apprenants, donnez-leur du travail et corrigez plus vite, avec l'IA en assistante. Vous gardez la décision.
Commencer gratuitementGratuit jusqu'à 3 apprenants · Votre espace prêt en 2 minutes